Проверил HyperFrames и OpenEdit на 15-минутном видео: что ИИ сделал сам, сколько занял рендер и почему быстрый черновик еще не означает готовый монтаж.
Нейросеть, которая сама монтирует видео: что получилось после 60+ часов тестов
Все началось с того, что мое видео забраковали.
Я записал обычный для себя 15-минутный ролик: сам в кадре, рассказываю тему для менеджеров отдела продаж, в процессе показываю наш калькулятор. После публикации получил прямую обратную связь: видео выглядит плохо, как будто его сделали в 2020 году.
По сути забраковали не только монтаж. Забраковали и меня как автора подачи. Я в кадре, я рассказываю, я отвечаю за то, как это выглядит и насколько зрителю вообще хочется смотреть дальше.
Можно было спорить со вкусами, искать монтажера или самому глубже разбираться в видеоредакторах. Но в этот момент у меня возник более интересный вопрос.
Параллельно интернет забит роликами и демонстрациями, где все выглядит почти магически: загрузил исходник, ИИ сам понял содержание, смонтировал все под ключ, добавил графику, видеовставки и анимацию, а через несколько минут у тебя результат чуть ли не студийного уровня.
Ну вот я и решил попробовать.
Разве в 2026 году эту работу уже нельзя просто отдать ИИ? Не сгенерировать ролик из текста и не нарезать часовое интервью на короткие вертикальные видео. У меня уже есть готовый исходник: я в кадре, рассказываю конкретную тему для менеджеров отдела продаж и показываю наш калькулятор.
Я хочу загрузить именно это видео в систему и получить обратно современно оформленный длинный ролик. Чтобы ИИ сам понял содержание, решил, где оставить меня в кадре, где вывести короткий тезис, где показать калькулятор, а где добавить графику, изображение, дополнительную видеовставку или движение. И чтобы после этого мне осталось посмотреть результат, исправить несколько спорных мест и опубликовать видео.
Можно ли сегодня дать длинное видео нейросети и получить автоматический монтаж?
В моих тестах ИИ уже может примерно за время, сопоставимое с длительностью ролика, собрать убедительный первый черновик 15-минутного видео. Но после одной команды готового к публикации результата я не получил: остались проблемы с количеством текста, композицией, нагрузкой на зрителя и ручной проверкой. А финальный экспорт одного из тестов занял 108 минут 28 секунд.
По моему подсчету, на проверку всей этой задачи у меня уже ушло больше 60 часов.
Что я вообще считал хорошим результатом
Мне не нужен рекламный ролик уровня большого продакшна. У меня уже есть конкретный горизонтальный исходник примерно на 15 минут. В кадре я. Рассказываю тему для менеджеров отдела продаж, привожу примеры, в процессе показываю наш калькулятор и его интерфейс.
Задача не в том, чтобы заменить меня аватаром или пересобрать смысл ролика. Нужно нормально оформить именно мое видео и помочь зрителю лучше воспринимать то, что я рассказываю.
Такое видео нужно немного оживить. Зритель в первую очередь должен понимать мысль. Визуальный слой должен помогать ее воспринимать, а не превращать просмотр в чтение презентации поверх речи.
Где-то достаточно немного изменить крупность кадра.
Где-то полезен короткий тезис.
Где-то нужно показать интерфейс.
Где-то мысль лучше передать изображением, схемой или визуальной метафорой.
А иногда правильное решение - вообще ничего не добавлять.
Последнее оказалось неожиданно важным.
Технически сегодня уже не очень сложно что-нибудь нарисовать поверх видео. Гораздо сложнее понять, нужно ли это вообще рисовать.
Почему сначала мне казалось, что задача давно решена
Раньше я уже описывал, как вообще пришел к автоматизации видеомонтажа и почему первая попытка через Codex и CapCut привела меня к программной сборке визуального слоя.
После этой обратной связи я пошел искать готовое решение. Посмотрел больше десятка роликов, читал статьи, инструкции, рекламные страницы и лид-магниты, пробовал готовые продукты и разные подходы.
И в интернете эта задача выглядит почти решенной. Загружаешь свое видео. ИИ распознает речь, понимает содержание, сам решает, что показать, убирает лишнее, добавляет субтитры, видеовставки, графику и анимации, учитывает нужный стиль. Через несколько минут получаешь практически готовый ролик. Под ключ. Быстро. Красиво.
Мне нужен был именно такой сценарий, поэтому я и решил проверить его на своем видео. Но чем глубже я разбирался, тем заметнее становилась разница между двумя утверждениями. Сервис умеет добавлять графику и видеовставки. И: Сервис способен хорошо оформить 15 минут связного видео.
Первое сегодня встречается часто. Второе оказалось намного более сложной задачей.
Я специально убрал из эксперимента собственные решения
К этому моменту я уже сам довольно глубоко залез в тему. У меня появились собственные правила, смысловая разметка, логика сцен, программная композиция и эксперименты со скоростью рендера. Но если я сначала сам решу, что должно происходить на каждой секунде, а потом передам готовую инструкцию чужому инструменту, тест получится нечестным. Так я проверю только исполнительный движок.
Меня интересовало другое: Может ли готовая система сама выступить монтажером и режиссером?
Поэтому для тестов OpenEdit и HyperFrames я оставил только:
- исходное горизонтальное видео;
- транскрипцию с таймкодами;
- отдельную запись интерфейса;
- другое видео как визуальный референс;
- одно общее задание.
Без моей карты сцен, готовой драматургии и заранее придуманных карточек. Без указаний, на какой секунде что показать.
Задача была простой:
Пойми все видео целиком и самостоятельно сделай современный, динамичный и визуально цельный монтаж.
Я хотел посмотреть, что получится после одной команды.
Первый HyperFrames почти ничего не сделал
Первый прогон оказался довольно показательным. Я в кадре, субтитры снизу, большой текст сбоку и небольшие приближения и отдаления камеры.

Первый черновик HyperFrames. Система уловила тему ролика, но по факту свела монтаж к крупному тексту слева, субтитрам и легким зумам.
При этом содержание система понимала не так уж плохо. Она разбила длинное видео на смысловые части и сформулировала вполне внятные тезисы:
«Проблема начинается раньше сообщения».
«Кто? Что? Когда?»
«Важны не слова. Важна функция».
То есть текст она в целом понимала. Но способность понять, о чем говорю я, еще не означала способность понять, как это лучше показать.
Потом результат стал заметно лучше
Позже выяснилось, что для такой задачи у HyperFrames есть специализированный режим /talking-head-recut. Я запустил эксперимент еще раз. Примерно через 15 минут у меня был оформлен почти 16-минутный ролик.

Во втором прогоне картинка стала ощутимо сильнее: система собрала вступление в едином стиле и уже выглядела как настоящий черновик длинного ролика.
Теперь система сама добавляла разные карточки, крупные тезисы, списки, сравнения, цитаты, боковые панели и разные варианты композиции.
Когда речь дошла до калькулятора, система сама использовала запись интерфейса примерно там, где это действительно было уместно.

Один из лучших фрагментов HyperFrames: во время рассказа о калькуляторе сервис встроил запись интерфейса и оформил этот момент как отдельный визуальный блок.
На первых сценах результат производит сильное впечатление. Еще 15 минут назад был обычный исходник. Теперь перед тобой визуально оформленное длинное видео, причем почти без ручной работы. А потом я начал смотреть его уже не как автор эксперимента, которому приятно, что ИИ вообще что-то сделал, а как обычный зритель. И впечатление изменилось.
Проблема оказалась не в красоте отдельных кадров
Многие отдельные кадры выглядели вполне прилично.

На уровне стоп-кадра многое выглядит интересно. Но когда таких экранов становится много, зрителю приходится одновременно слушать, читать и следить за композицией.
Проблема проявлялась при просмотре видео целиком. Я говорю. Одновременно появляется большой тезис. Рядом второй текст. Иногда еще одна карточка. Снизу продолжаются субтитры. В центре остаюсь я.
Зрителю постоянно приходится решать, куда направить внимание. Слушать меня, читать главный тезис, читать дополнительный текст, следить за субтитрами или смотреть на меня.
Отдельный стоп-кадр может выглядеть эффектно. Пятнадцать минут такого просмотра уже начинают утомлять. Именно здесь для меня стала понятна разница между визуальным оформлением и режиссурой.
Добавить еще один элемент система умеет довольно хорошо. Гораздо труднее решить, что в конкретный момент лучше ничего не добавлять.
Почти любая мысль превращалась еще в один текст
Постепенно проявилась еще одна закономерность. HyperFrames действительно понимал многие тезисы, но дальше часто происходила примерно одна операция: понять мысль -> переформулировать -> положить ее в красивую карточку
Получалась презентация поверх меня. Хотя текст - только один из способов что-то объяснить.
Если я объясняю менеджеру развилку в следующем шаге по клиенту, ее можно показать визуально.
Если сравниваю два сценария действия, это можно выразить композицией.
А когда я показываю наш калькулятор, иногда лучше вообще убрать дополнительное объяснение и дать зрителю посмотреть на интерфейс.
Но в моем тесте система снова и снова возвращалась к текстовым блокам. В результате автоматический монтаж часто добавлял зрителю новую работу вместо того, чтобы облегчать восприятие.
Иногда графика не учитывала, что я важнее
Были и более простые ошибки.
Карточка заходила мне на лицо.
Большой блок конкурировал со мной в кадре.
Композиция технически была собрана, но визуальный приоритет объектов оказывался странным.
Нужно учитывать, где находится мое лицо, что я делаю руками, куда смотрю, насколько в этот момент важен именно я в кадре и сколько информации зритель уже должен воспринимать одновременно. Хороший автоматический монтаж требует не только генерации элементов, но и постоянного управления вниманием.

Такие сцены смотрятся аккуратно, но они же хорошо показывают главную проблему: сервис чаще думает карточками и чеклистами, чем реальным управлением вниманием зрителя.
Референс тоже не дал того эффекта, которого я ожидал
В систему было загружено другое видео как визуальный референс. Я хотел проверить, сможет ли ИИ перенести хотя бы общие принципы:
- ритм;
- плотность оформления;
- характер движения;
- композицию;
- типографику;
- соотношение меня с дополнительными элементами.
В моем тесте HyperFrames скорее придумал собственную визуальную систему. Она была достаточно последовательной: темный фон, контрастная типографика, карточки, повторяющиеся приемы. Но явной связи с исходным референсом я не увидел. В этом конкретном прогоне я подтвердил способность системы автоматически придумать оформление.
Способность последовательно перенести визуальный язык референса на новое длинное видео я не подтвердил.
OpenEdit дал другой, но тоже ограниченный результат
Параллельно я сделал похожий чистый тест через OpenEdit. Те же исходные материалы, та же задача, никакой моей собственной карты монтажа. Он обработал видео целиком, добавил русские субтитры, смысловые заголовки, немного движения кадра и в одном месте довольно органично использовал запись интерфейса.

В тесте OpenEdit результат был гораздо скромнее: в основном это мое видео, субтитры и простой заголовочный слой.

Один из немногих моментов, где OpenEdit сделал полезную встройку: во время рассказа о конструкторе система показала интерфейс и не стала дробить кадр на слишком много элементов.
Но полноценного визуального монтажа в моем прогоне снова не получилось. Большую часть времени в кадре оставался я с текстовым оформлением. Кроме того, предварительный просмотр в моем конкретном тесте заметно дергался. Точную техническую причину я не устанавливал, поэтому не считаю это доказанной проблемой самого OpenEdit.
Для моего эксперимента важнее другое: После одной общей команды готового к публикации длинного ролика я снова не получил.
Потом я запустил финальный экспорт
Черновик HyperFrames появился примерно за время, сопоставимое с длительностью исходного видео. Около 15 минут. Это действительно быстро. После этого я запустил финальный экспорт. Длительность исходного ролика - 15 минут 50 секунд.
Параметры моего запуска:
- MP4;
- 1920x1080;
- 30 кадров в секунду;
- режим качества Standard.
Финальный рендер занял: 108 минут 28 секунд.
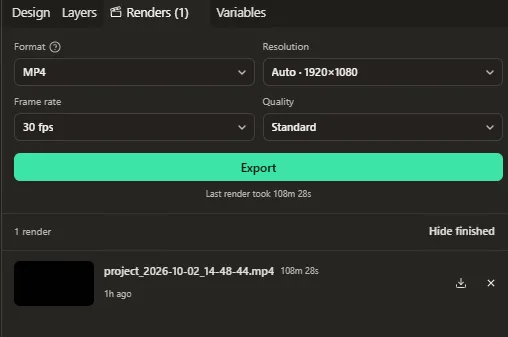
Главная цифра всего эксперимента. Первый автоматический черновик появился быстро, но экспорт итогового файла занял 108 минут 28 секунд.
В этом конкретном тесте это примерно в 6,85 раза дольше длительности готового видео. Средняя скорость получилась около 4,4 кадра в секунду. Поэтому время до первого черновика и время до готового файла здесь оказались совершенно разными показателями.
Итерации тоже оказались не бесплатными
Один такой прогон HyperFrames израсходовал примерно 14% недельного лимита моего Codex. Это показатель моего конкретного запуска и моего тарифа, а не универсальная стоимость использования HyperFrames. Но для моей задачи он важен, потому что хороший ролик почти наверняка требует нескольких итераций.
Нужно посмотреть все 15 минут.
Найти перегруженные сцены.
Убрать лишние тексты.
Исправить блоки поверх лица.
Заменить часть карточек изображениями или интерфейсом.
Переделать неудачные композиции.
Снова проверить результат.
После этого нужен новый экспорт.
Поэтому фраза «ИИ сделал монтаж за 15 минут» в моем тесте означала только одно: примерно через 15 минут появился первый автоматический черновик. До готового видео было еще далеко.
На что на самом деле ушли мои 60+ часов
Большая часть времени ушла вообще не на ожидание одного рендера, а на попытку понять саму функцию монтажа длинного видео. Сначала задача кажется набором уже решенных технических операций:
- Распознать речь.
- Добавить субтитры.
- Сделать карточку.
- Поставить картинку.
- Изменить крупность.
- Вставить дополнительное видео.
Отдельно почти каждый такой элемент уже доступен. Сложность находится между ними.
Нужно понять не отдельную фразу, а ход повествования.
Определить функцию текущего фрагмента.
Решить, нужен ли здесь дополнительный визуальный слой.
Если нужен - выбрать подходящую форму.
Не повторять текстом то, что я и так говорю.
Не перегружать зрителя.
Не закрывать мне лицо.
Не превращать каждую мысль в презентационный слайд.
Соблюдать ритм на протяжении всего ролика.
Помнить уже использованные приемы.
Учитывать визуальный референс.
И после этого еще достаточно быстро собрать конечное видео.
В такой постановке задача уже мало похожа на простое добавление нескольких ИИ-функций в видеоредактор.
Как изменился мой исходный вопрос
Я начинал с вопроса: Какая нейросеть сможет смонтировать мне видео?
После этих экспериментов вопрос для меня изменился: Какую часть функции видеомонтажа уже действительно можно передать цифровой системе?
Часть работы ИИ уже забирает очень хорошо. Он может быстро разобрать длинную речь, предложить структуру, сгенерировать визуальные элементы и собрать первый черновик. Работа, на которую раньше человек мог потратить часы, действительно может появиться за минуты.
Но первый черновик еще не означает, что вся функция выполнена. Если после автоматической генерации мне нужно несколько часов исправлять когнитивную нагрузку, переставлять элементы, переписывать тексты, проверять композицию и ждать долгий финальный рендер, ручная работа не исчезает.
Она перемещается на другой этап. Этот разрыв между быстрым автоматическим черновиком и готовым результатом оказался для меня главным результатом первых 60+ часов.
В итоге я все-таки решил задачу для себя
После этих экспериментов я собрал другой процесс. В нем сначала система должна понять, что зритель должен получить из конкретного фрагмента и нужен ли ему дополнительный визуальный слой. Только после этого принимается решение, что именно показывать.
Отдельно пришлось разбираться со скоростью исполнения. В моем текущем тестовом контуре сопоставимое длинное видео рендерится примерно за три минуты, а не за 108. Это результат моего собственного текущего теста, и подробно разбирать его я буду отдельно: с исходником, итоговым видео, замерами и количеством оставшейся ручной работы.
До этого я хочу проверить еще одну гипотезу. Возможно, я потратил больше 60 часов только потому, что не нашел нужный готовый продукт. Поэтому следующим шагом я запускаю отдельное исследование российского и зарубежного рынка автоматического монтажа длинных видео.
Мне нужно понять:
- какие сервисы действительно работают с видео от 10 минут;
- какие нормально работают с русской речью;
- кто умеет не только делать субтитры, но и принимать визуальные решения;
- где используются изображения, дополнительные видеовставки, интерфейсы, графика и движение;
- кто умеет работать с визуальным референсом;
- сколько ручных исправлений остается человеку;
- сколько занимает первый результат и финальный рендер;
- сколько все это реально стоит;
- что разумнее купить, интегрировать или продолжать делать самостоятельно.
После этого можно будет переходить к следующему вопросу: Есть ли здесь повторяющаяся работа и экономика, из которых вообще имеет смысл делать отдельный сервис.